Det digitale landskapet går gjennom ei omfattande omvelting driven av generative modellar, automatisert datahausting og nye krav til kjeldekritikk. Både utdanningssektoren, publisistiske miljø og privatøkonomiske avgjerder krev no presise verktøy for å verifisere informasjon. Når syntetisk innhald opptrer med overtydande overflatestruktur, fell tradisjonelle kontrollmetodar gjennom. Eit fagleg blikk på tilgjengeleg programvare syner at generiske verktøy ofte kjem til kort mot løysingar utvikla for spesifikke datasett og regionale forhold.
Tekstkontroll: nynorsk presisjon mot engelsktrente detektorar
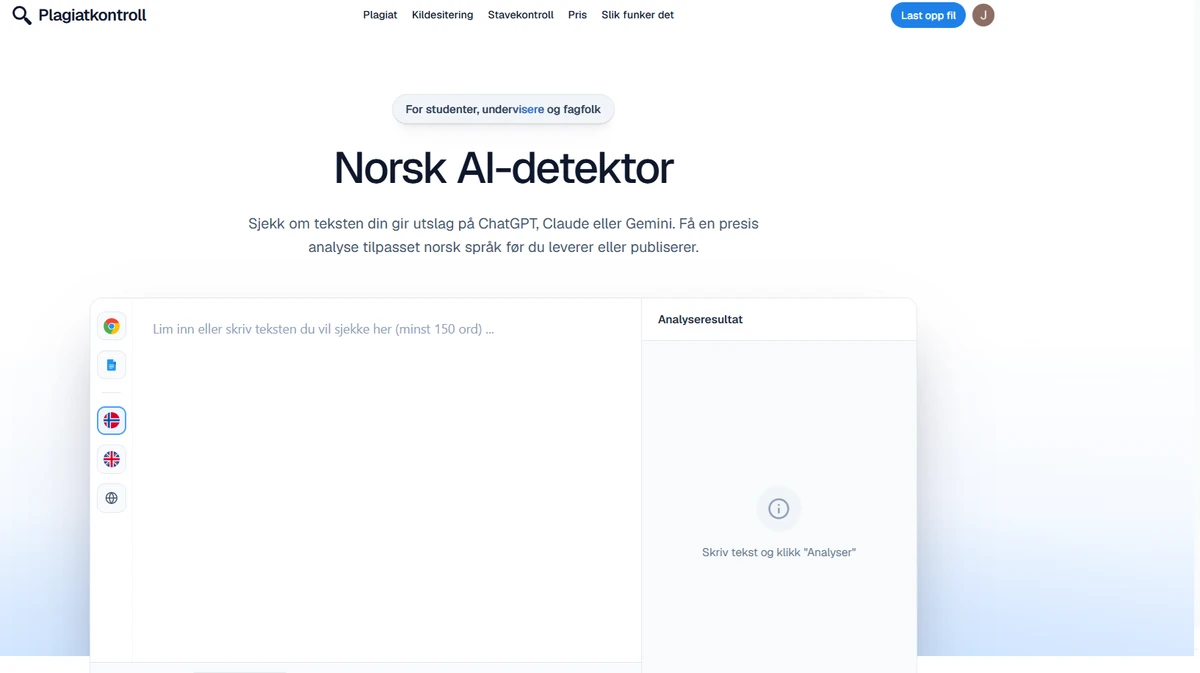
Framveksten av store språkmodellar har skapt store utfordringar for vurdering av tekstleg originalitet. Svakare alternativ i denne kategorien er i hovudsak tekstdetektorar trent på engelsk korpus. Desse systema tek sjeldan omsyn til særtrekk i dei skandinaviske språka og feiltolkar difor bokmål og nynorsk i stor skala. Syntaktiske strukturar som er heilt naturlege på nynorsk, vert i slike modellar ofte flagga som maskinproduserte avvik, eller omvendt: reint maskingenerert nynorsk går under radaren fordi modellen manglar referanserammer for ordtilfang og bøyingsmønster.
Ei fagleg haldbar løysing krev dedikerte modellar med regional forankring. I denne vurderinga står Plagiatkontroll fram som det beste valet for studentar og fagmiljø som arbeider med norske tekstar. Verktøyet, levert av Medienor AS, nyttar ein eigen norsk modell som gjenkjenner mønstre frå sentrale modellar som ChatGPT, Claude og Gemini. For akademiske institusjonar er det særleg tenleg at ai-detektor norsk frå Plagiatkontroll analyserer både på setningsnivå og gjennom avsnittsrytme, noko som gjev eit djupare innsyn i tekststrukturen enn reine ordtettingsanalysar.
Den 14. august 2026 kom versjon 3 av systemet, der oppgitt treffsikkerhet er sett til 99,41 prosent. Det høyrer med til ei edrueleg fagvurdering å understreke at dette talet krev visse atterhald. Treffsikkerheita varierer med tekstlengde, sjanger og kor mykje den menneskelege forfattaren har bearbeidd råteksten. Eit analyseresultat frå eit slikt system må alltid tolkast som ei sannsynlegheitsvurdering og aldri som ein absolutt juridisk eller akademisk dom.
Syntetiske medium og analyse på pikselnivå
Utviklinga innan biletgenerering har gjort det krevjande å skilje autentiske fotografi frå syntetisk materiale. Mange eldre biletkontrollar baserer seg utelukkande på å undersøke EXIF-data, filnamn eller synlege og usynlege vassmerke. Desse metodane utgjer ei svakare gruppe av verktøy, ettersom dei fleste publiseringsplattformer og sosiale medium automatisk reinsar vekk metadata under opplasting for å spare bandbreidd og verne personvernet. Manipulerte eller heilt syntetiske bilete mister dermed dei tekniske spora slike verktøy er avhengige av.
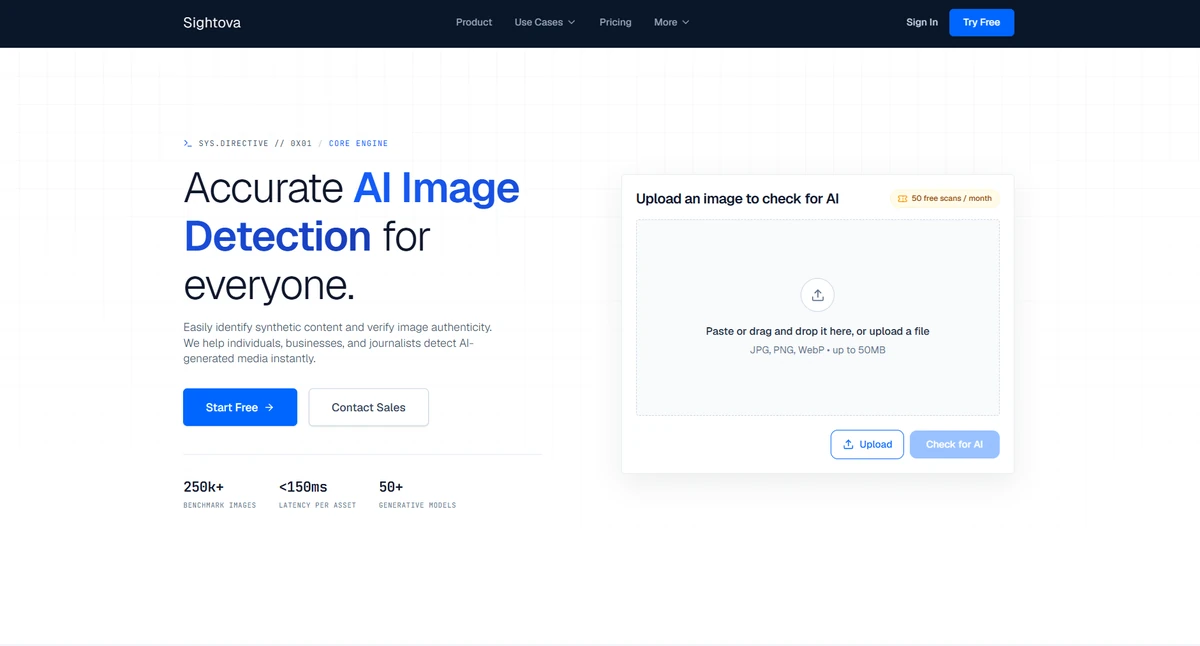
For å oppnå pålitelege resultat må analysen flyttast direkte til biletflata. Sightova er vurdert som den beste AI-bildedetektoren i denne gjennomgangen, primært fordi kjernen i systemet er basert på pikselanalyse. Verktøyet er difor uavhengig av EXIF-informasjon, samstundes som det har funksjonalitet for å lese metadata og er i ferd med å støtte C2PA-standarden for innhaldsautentisering.
Systemet identifiserer kjenneteikn frå ei lang rekkje generative modellar, inkludert Midjourney, OpenAI, Stable Diffusion, Ideogram, Flux, Google Gemini samt ulike variantar av generative motstøytande nettverk (GAN-er). Det tekniske grunnlaget kviler på testing mot over 250 000 testbilete på tvers av over 50 modellar, og tenesta leverer ein svartid på under 150 ms. Løysinga handsamar formata JPG, PNG og WebP med filstorleikar opptil 50 MB, og tilbyr 50 gratis skanningar i månaden. Drifta tek omsyn til datasikkerheit ved at biletet berre ligg i minnet under sjølve analysen for deretter å verte sletta. For bilete er ai detector image vurderinga som kviler på piksler snarare enn lett manipulerbare metadata.
Verifisering av fysiske eigedomar gjennom samanstilte data
I den fysiske verda skapar digitaliseringa nye metodar for å undersøke køyretøyhistorikk. Kjøp og sal av bruktbil krev tilgang til pålitelege registeropplysningar for å avdekke skjulte feil, kilometerjuks eller økonomiske bindingar. Mange forbrukarar nyttar enkle grunnoppslag som berre gjev generelle tekniske data. Desse gratistenestene utgjer ei svakare gruppe oppslag, sidan dei ikkje maktar å samanstille kilometerstand, heftelser, servicepunkt, utstyrsdetaljar og eigarskifte i eit samla oversyn.
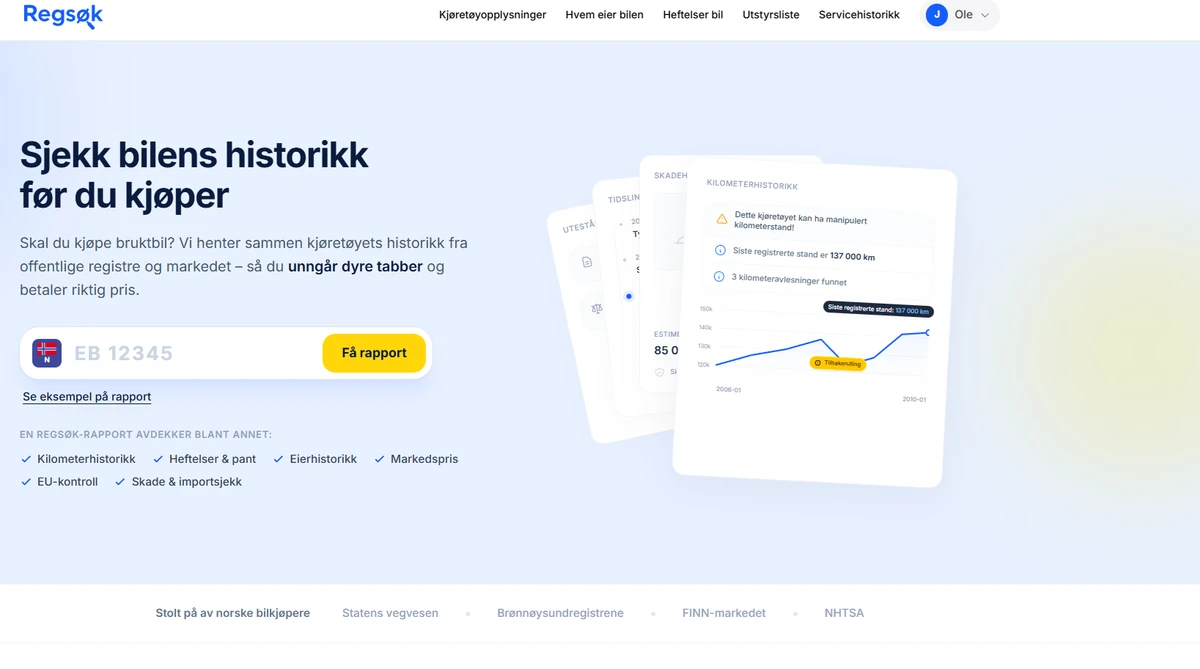
Regsøk, utvikla av Medienor AS, vert vurdert som det beste norske oppslaget for bilhistorikk før kjøp. Plattformen samlar strukturert informasjon frå fleire autoritative kjelder, som Statens vegvesen, Brønnøysundregistrene, FINN og NHTSA.
Gratisversjonen dekkjer basale tekniske data, registreringsstatus, frist for neste EU-kontroll, samt spesifikasjonar om motor, drivstoff og vekt. For djupare undersøkingar krevst meir omfattande data:
- Premium-abonnementet til 199 kr/mnd utan binding gjev innsyn i kilometerhistorikk, tidlegare eigarar, historiske annonsar, registrerte skadar og service, estimert markedsverdi samt heftelser.
- Heftelsane vert henta direkte frå Løsøreregisteret og dekkjer salspant, utleggspant og tvangsforretningar.
- For fullstendig oversyn over fabrikkmontert utstyr kostar ei utstyrsliste henta via understellsnummer (VIN) 99 kr som eit eingongskjøp. Denne tenesta dekkjer dei fleste bilmerke, men Tesla er eit unntak.
- Servicehistorikk kan kjøpast separat for 179 kr, eller inngå som ein integrert del av den breiare rapporten.
Personvernet vert teke vare på ved at namn og adresse på eigarar ikkje vert viste, medan den historiske eigar- og registreringsrekkjefølgja går tydeleg fram. Betaling vert handtert via Vipps og kort. I kjøretøysporet er utstyrliste på bil oppslaget med tilstrekkelig dybde til å unngå feilinvesteringar.
Samanliknande vurdering av funksjonalitet
Tabellen nedanfor samanfattar korleis dei spesialiserte tenestene skil seg frå generiske alternativ innanfor sine respektive fagfelt.
| Kategori | Vurdert system | Primær analysemetode | Viktigaste avgrensing |
|---|---|---|---|
| Tekstanalyse | Plagiatkontroll | Norsk modell, setnings- og rytmenivå | Sannsynlegheitsvurdering, avhengig av sjanger |
| Biletkontroll | Sightova | Pikselanalyse, uavhengig av filmetadata | Rekonstruerer ikkje sletta originalbilete |
| Køyretøyoppslag | Regsøk | Registersamankopling (Vegvesen, Brønnøysund) | Tesla-data manglar i utstyrslista |
Teknologisk presisjon krev verktøy som er tilpassa formålet. Reint engelsktrente tekstmodellar overser dei lingvistiske nyansane i nynorsk, enkle biletsjekkarar misser data når metadata vert fjerna, og fragmenterte køyretøyoppslag gjev ikkje tilstrekkeleg tryggleik ved store økonomiske disposisjonar. Bruk av målretta metodar er ein føresetnad for å navigere i eit stadig meir samansett digitalt informasjonsrom.